Ein fester Maßstab für personalisierte KI-Missionen
Rolle, Tool und Starthilfe anpassen – aber der Bewertungsmaßstab bleibt gleich, damit personalisierte KI-Übungen dieselbe Kompetenz nachweisen.
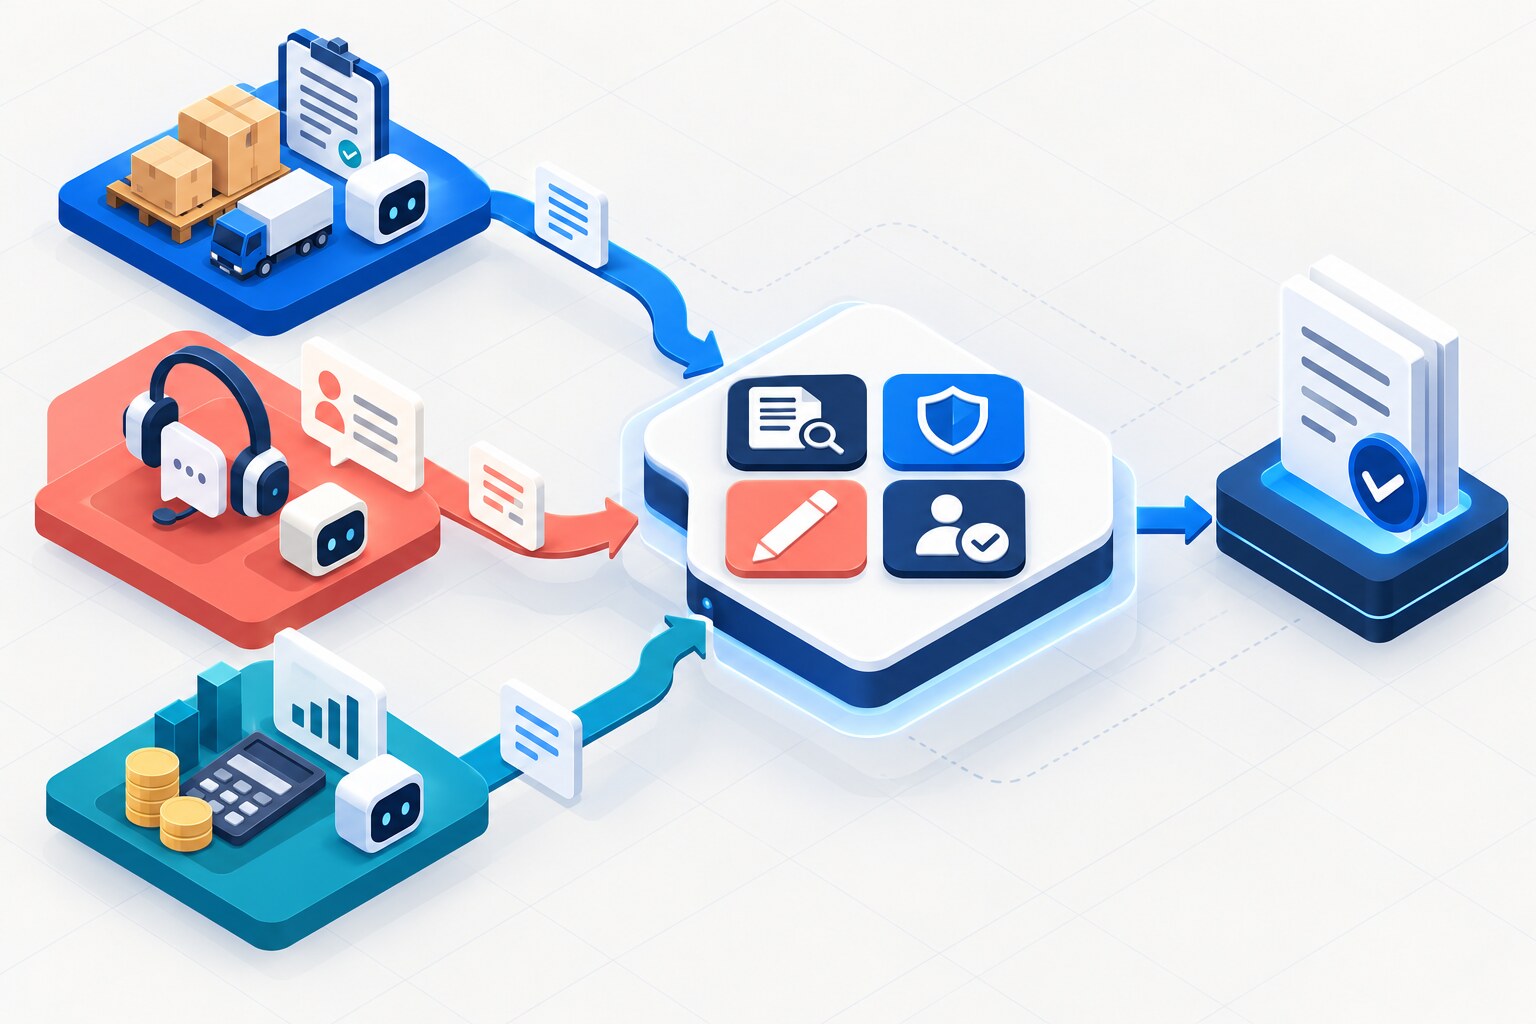
Personalisiertes KI-Training kann leicht inkonsistent werden. Ein Lernender im Einkauf bekommt einen Lieferantenfall, im Support einen Kundenfall, in der Finanzabteilung einen Abweichungsfall. Nicht nur die Details ändern sich, sondern auch die Erfolgskriterien. Einer wird für flüssiges Schreiben belohnt, ein anderer für Quellenprüfung, ein dritter für Tempo. Das Programm wirkt maßgeschneidert, doch der Leistungsnachweis ist nicht mehr vergleichbar.
Ein gutes Bokili-Missionsdesign trennt, was angepasst wird und was fix bleibt. Passen Sie Rolle, Tool, Starthilfe und Kontext an. Behalten Sie aber einen einheitlichen Bewertungsmaßstab für das Zielverhalten bei. Personalisierung soll Lernenden helfen, eine Kompetenz von ihrem jeweiligen Startpunkt aus zu erreichen, statt verschiedene Kompetenzdefinitionen zu schaffen.
Die Design-Regel
Ändern Sie den Übungskontext, aber nicht den erforderlichen Kompetenznachweis.
Personalisierung braucht einen gemeinsamen Bezugspunkt
Bokili beschreibt öffentlich kurze Missionen, die an Rolle, Level und KI-Tools der Lernenden angepasst sind. Das ist sinnvoll, denn laut den KI-Kompetenz-Leitlinien der EU-Kommission sollen Organisationen Wissen, Erfahrung, Schulung und Nutzungskontext des KI-Systems berücksichtigen. Die Leitlinien erlauben auch unterschiedliche Lernansätze. Kontextsensitives Lernen ist nicht das Problem, sondern uneinheitliche Bewertungsmaßstäbe.
Das US Office of Personnel Management definiert Schulungsbedarf als Lücke zwischen Soll- und Ist-Leistung. Das impliziert zwei Anker: Die Soll-Leistung muss klar sein und die Leistung des Lernenden muss damit verglichen werden. Ändert sich die Anforderung mit dem Szenario, ist unklar, ob der Lernende sich verbessert hat oder nur eine leichtere Aufgabe löste.
| Festhalten | Anpassen | |
|---|---|---|
| Zielverhalten | Die beobachtbare Kompetenz, die geübt wird | Die rollenbezogene Aufgabe, die der Kompetenz Bedeutung gibt |
| Nachweis | Was für das Bestehen gezeigt werden muss | Quellen, Dateitypen und Einzelheiten des Szenarios |
| Regeln | Die nicht verhandelbare Grenze für Daten und Befugnisse | Das freigegebene Tool und der verfügbare Arbeitsbereich |
| Hilfe | Der abschließende eigenständige Nachweis | Beispiele, Prompts, Hinweise und der Schwierigkeitsgrad am Ausgangspunkt |
Der ANCHOR-Bewertungsmaßstab
Ein Maßstab für alle rollenbasierten Missionen
A – Artefakt
Benennen Sie das nützliche Ergebnis, das der Lernende erstellen muss: ein geprüftes Briefing, ein korrigierter Entwurf, eine Klassifizierung oder ein Entscheidungsprotokoll.
N – Benannter Nachweis
Jede wesentliche Entscheidung muss durch eine Quelle, Berechnung, Richtlinie oder ein Akzeptanzkriterium belegt werden.
C – Korrektur
Eine Überarbeitung muss sichtbar sein. Lernende sollen zeigen, was sie nach Prüfung des ersten Entwurfs geändert haben.
H – Letztentscheid
Der Lernende muss angeben, was er genehmigt, ablehnt, eskaliert oder offenlässt.
O – Handlungsrahmen
Es gelten dieselben Regeln für erlaubte Eingaben, genehmigte Tools und verbotene Aktionen.
R – Wiederholung
Das Verhalten an einem neuen Fall testen, damit Erinnerung nicht fälschlich als Transferleistung gilt.
ANCHOR ist kein universeller Score für jede KI-Kompetenz, sondern eine Designvorlage für ein Programm. L&D sollte das beobachtbare Verhalten wählen und jedes Feld definieren, bevor die Mission angepasst wird. Eine Mission zur Quellenprüfung kann verlangen, dass jede Aussage auf die Unterlagen zurückführbar ist. Eine Datenschutz-Mission kann fordern, dass Lernende ein gesperrtes Feld ablehnen, bevor sie einen Prompt schreiben.
Lesen ist der Anfang. Üben macht den Unterschied.
Jetzt startenAnwendungsbeispiel: eine Kompetenz, drei Rollen
Angenommen, das Zielverhalten ist die Trennung von Fakten und Schlussfolgerungen. Der Bewertungsmaßstab ist fix: Lernende müssen ein kurzes Arbeitsergebnis erstellen, jede wesentliche Aussage als „belegt“ oder „abgeleitet“ kennzeichnen, Belege mit der Quelle verknüpfen, einen unbelegten Satz korrigieren und den finalen Entscheider benennen.
Drei Missionen, ein Standard
- 1
Einkauf
Vergleichen Sie drei fiktive Lieferanten-Updates und markieren Sie eine unbestätigte Lieferzusage. Der Lernende entscheidet, was in das Briefing für den Einkäufer gehört.
- 2
Kundensupport
Wandeln Sie eine fiktive Fallhistorie in eine interne Eskalationsnotiz um. Der Lernende trennt, was der Kunde gemeldet hat, von der wahrscheinlichen Ursache.
- 3
Finanzen
Erklären Sie eine fiktive Budgetabweichung anhand eines kleinen Datenpakets. Der Lernende unterscheidet zwischen berechneten Differenzen und möglichen Erklärungen.
- 4
Prüfung
Bewerten Sie alle drei mit demselben ANCHOR-Maßstab. Vergleichen Sie nicht den Schreibstil zwischen den Rollen, sondern ob Nachweis, Korrektur und menschliche Verantwortung sichtbar sind.
Die Missionskarten sollten nicht identisch sein. Der Einkauf kann eine Vergleichstabelle nutzen, der Support eine Zeitleiste und die Finanzabteilung ein kleines Spreadsheet. Anfänger erhalten ein kommentiertes Beispiel, erfahrene Lernende weniger Hinweise. Diese Anpassungen reduzieren irrelevante Schwierigkeiten. Der Leistungsnachweis bleibt vergleichbar, weil das Zielverhalten dasselbe ist.
Achten Sie auf Scheinkonsistenz
Derselbe Prompt, Timer oder Test für alle wirkt fair, prüft aber möglicherweise das Falsche. Ein Text voller Fachsprache aus dem Einkauf benachteiligt gute Marketer, ohne etwas über die Quellenprüfung zu verraten. Der umgekehrte Fehler ist eine Überpersonalisierung, bis jeder Lernende eine private Bewertungsmatrix hat. Echte Konsistenz liegt im Nachweis der Kompetenz, nicht in identischen Aufgaben.
Personalisiertes Missions-Set prüfen
- Das beobachtbare Verhalten ist in jeder Variante gleich formuliert.
- Jede Variante verlangt dieselbe Kategorie von Nachweisen.
- Rollendetails ändern den Kontext, nicht den Maßstab für das Bestehen.
- Toolspezifische Schritte entsprechen dem tatsächlichen Zugriff der Lernenden.
- Hinweise passen zum Ausgangsniveau, entfallen aber vor dem abschließenden Nachweis.
- Sicherheits- und Entscheidungsgrenzen werden für vertraute Rollen nicht gelockert.
- Eine prüfende Person kann erklären, warum zwei unterschiedliche Arbeitsergebnisse bestehen.
- Die nächste Mission folgt aus der beobachteten Lücke, nicht allein aus der Berufsbezeichnung.
Diese Methode erweitert Bokilis bestehende Leitlinien zu rollenbasierten KI-Kompetenzen, mehrsprachigem Training mit einem gemeinsamen Standard und geführten Missionen, die echte Entscheidungen erhalten. Bokilis öffentliche Features beschreiben rollenadaptive Missionen und sichtbaren Kompetenzfortschritt; eine feste Messlatte für den Nachweis ist die Design-Disziplin, die diese beiden Ideen verbindet.
- Wählen Sie ein Verhalten, das drei Rollen benötigen, zum Beispiel eine wichtige Aussage zu prüfen.
- Definieren Sie Arbeitsergebnis, Nachweis, Korrektur und menschliche Entscheidung, die zum Bestehen nötig sind.
- Erstellen Sie drei einzeilige Rollenszenarien, ohne diese Anforderungen zu ändern.
- Kennzeichnen Sie, welche Tools, Hilfen und Quellenpakete variieren dürfen.
- Lassen Sie prüfen, ob derselbe Nachweis-Maßstab alle drei Versuche beurteilen kann.
- Entfernen Sie jedes Rollendetail, das die Kompetenz statt nur den Kontext verändert.
Personalisieren Sie den Weg, nicht das Ziel.
Rollenrelevanz hilft Lernenden, die Aufgabe zu erkennen. Niveaugerechte Unterstützung erleichtert den Einstieg. Tool-Anpassungen halten Anleitungen praxistauglich. Keine dieser Entscheidungen sollte die Vergleichbarkeit von Kompetenzen verhindern. Behalten Sie einen sichtbaren Nachweis-Standard bei, passen Sie den Weg dorthin an und lassen Sie den Versuch des Lernenden die nächste nützliche Mission aufzeigen. So wird Personalisierung zum Fortschritt statt zur reinen Variation.
Quellen
- Features — AI training for teams — Bokili
- AI training for HR & L&D leaders — Bokili
- AI Literacy — Questions & Answers — European Commission
- Planning & Evaluating — Training Needs Assessment — U.S. Office of Personnel Management
Lesen ist der Anfang. Üben macht den Unterschied.
Bokili macht aus solchen Fähigkeiten Zehn-Minuten-Missionen für das ganze Team – mit sofortigem Feedback und sichtbarem Fortschritt.
Jetzt startenWeiterlesen
KI-Trainingsplattform für Unternehmen: Ein Probelauf zur Barrierefreiheit
Testen Sie vor der Auswahl einer KI-Plattform eine komplette Lernreise mit Tastatur, Zoom, Screenreader und Fehlerbehebung.
ChatGPT-Schulung für Mitarbeitende: Importierte Texte als Daten behandeln
So lernen Mitarbeitende, den Task stabil zu halten, wenn E-Mails oder Dokumente Anweisungen enthalten, die die KI analysieren – nicht befolgen – soll.
KI-Aufgabe abschließen: Speichern, archivieren oder löschen?
Verantwortungsvoller KI-Einsatz heißt, für jeden Prompt, jede Quelle, jeden Entwurf und jedes Ergebnis eine Abschlussentscheidung zu treffen – nicht nur das Endergebnis zu prüfen.