Un score moyen peut masquer les échecs qui comptent
Un bon résultat global peut dissimuler une faiblesse sur un segment à fort enjeu. Évaluez l'IA par tâche, contexte et impact avant de baser votre décision sur la moyenne.
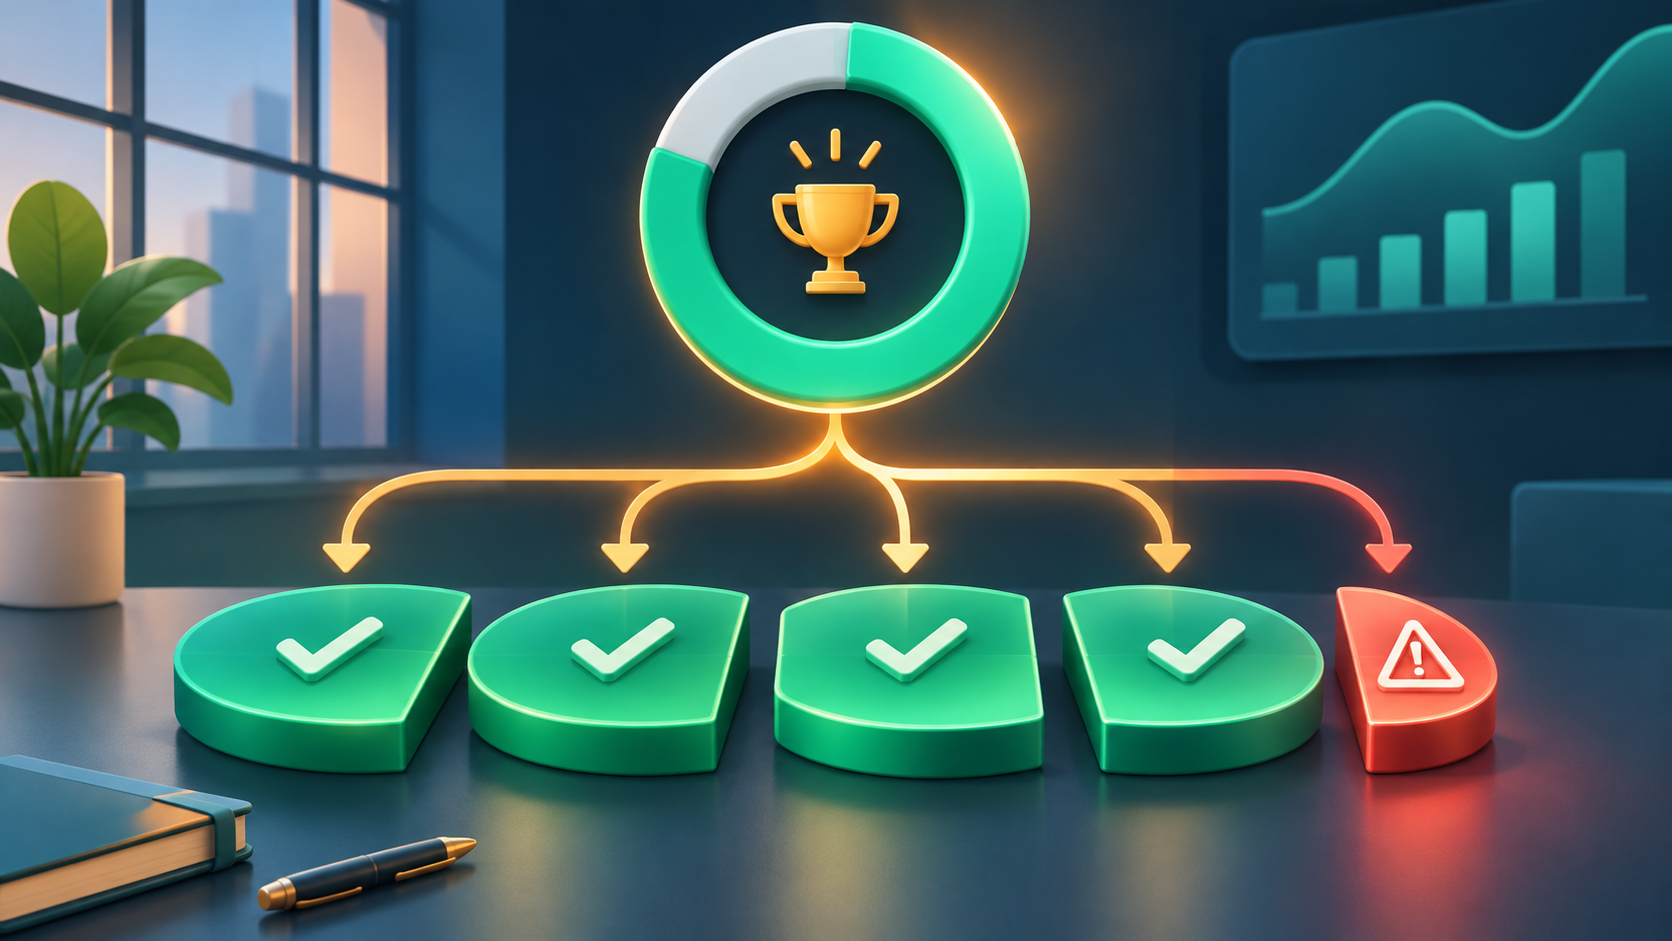
Un score de test IA unique est facile à citer : 91 % de précision, 4,3 sur 5, ou « 46 cas sur 50 réussis ». Il est aussi facile de mal l'interpréter. La moyenne peut agréger des tâches routinières et critiques, des contextes courants et rares, des requêtes claires et ambiguës, ou des utilisateurs aux besoins hétérogènes. Quatre bons segments peuvent en masquer un mauvais.
La solution n'est pas de rejeter les moyennes, mais de les remettre à leur juste place. Avant qu'un score ne justifie un déploiement, segmentez l'évaluation selon les cas où la performance, l'impact ou l'expérience utilisateur peuvent varier. Le AI Risk Management Framework du NIST préconise des jeux de tests réalistes, des conditions documentées et des limites de généralisation. De même, les directives britanniques soulignent que l'impact de l'IA varie selon la tâche, le contexte et le groupe. Un résultat sans ces conditions est un titre, pas encore une décision.
La moyenne répond à la mauvaise question
| Test global uniquement | Test par segments | |
|---|---|---|
| Question | Quelle est la performance globale du système ? | Où la performance change-t-elle assez pour modifier l’usage ? |
| Jeu de test | Un seul échantillon agrégé | Des segments nommés par tâche, contexte et conséquence |
| Résultat | Une moyenne ou un taux de réussite | Le résultat global et chaque segment important |
| Décision | Déployer ou rejeter | Déployer, limiter, revoir, renforcer la validation ou arrêter |
Imaginons qu'un assistant interne réponde correctement à 88 questions de politique sur 100. Cela semble utile. Mais ces 100 cas incluent 80 questions courantes, 15 variantes régionales et 5 exceptions urgentes. S'il répond correctement à 76 questions courantes, 10 régionales et seulement 2 exceptions urgentes, le score global reste de 88 %. Le segment qui pourrait causer le plus de tort est aussi le plus faible. Ajouter des cas faciles améliorerait la moyenne sans corriger cette faiblesse.
Utilisez la méthode SLICE avant de vous fier au score
SLICE : cinq questions pour une évaluation à fort enjeu
S — Statuer sur la décision
Définissez ce que le résultat autorisera : projet pilote, usage limité, déploiement large, revue obligatoire ou non-utilisation.
L — Lister les segments clés
Listez les types de tâches, langues, conditions d'entrée, contextes et niveaux de criticité où la performance pourrait varier.
I — Examiner chaque segment
Pour chaque segment clé, indiquez l'échantillon, la métrique, l'incertitude et les types d'échecs, pas seulement le score global.
C — Comparer les enjeux
Ne pondérez pas un cas rare à fort impact comme s'il était interchangeable avec un cas de routine.
E — Établir les limites
Pour les segments faibles ou non testés : revue humaine, périmètre réduit, tests additionnels, reconception ou arrêt du projet.
Lire, c'est bien. Pratiquer, ça change tout.
CommencerSLICE est une aide à la décision, pas un raccourci statistique. Certains segments seront trop petits pour un pourcentage stable. Mentionnez-le. Privilégiez l'analyse qualitative, les stress tests ciblés et les experts du domaine plutôt que d'inventer une fausse précision. Les 'Model Cards' proposent de documenter la performance par groupe et condition, car la pertinence d'un modèle dépend de son usage. Le AI Playbook britannique traite aussi le test, la validation et le suivi comme un travail continu, pas une simple étape de lancement.
Exemple pratique : des réponses aux conséquences inégales
Une entreprise teste un assistant IA sur les notes de frais. Le segment courant couvre les plafonds de repas, reçus et indemnités kilométriques. Le segment régional couvre les devises et règles fiscales locales. Le segment exceptionnel couvre les voyages médicaux, l'accessibilité et les réservations d'urgence. L'assistant est performant sur les questions courantes, fusionne parfois les règles régionales et omet souvent le valideur pour les exceptions. Le responsable ne noie pas le problème dans la moyenne. Il autorise l'outil pour les brouillons des cas courants, exige une source et une vérification humaine pour les cas régionaux, et redirige les exceptions à l'équipe compétente jusqu'à ce qu'un nouveau test prouve sa fiabilité.
Quoi documenter avec chaque score de test IA
- La décision visée et son responsable nommé
- Les conditions représentées dans le jeu de test
- Les segments importants et la raison de leur importance
- La taille de l’échantillon et l’incertitude de chaque segment
- Les types d’échecs, pas seulement les taux de réussite
- Les personnes, contextes ou cas absents du test
- La limite d’usage pour les segments faibles ou non testés
- La date, la version et le déclencheur du prochain test
Testez les segments cachés en 10 minutes
- Choisissez un résultat d’évaluation IA déjà utilisé par votre équipe.
- Écrivez la décision de travail que ce résultat doit éclairer.
- Répartissez les cas par type de tâche, conséquence et contexte susceptible de modifier la performance.
- Recalculez ou examinez qualitativement chaque segment séparément.
- Entourez le segment critique le plus faible ou le moins testé.
- Fixez une limite d’usage ou un test supplémentaire avant d’autoriser une utilisation plus large.
Une évaluation responsable ne demande pas si l'IA fonctionne, mais où, pour qui, dans quelles conditions, et ce qui se passe quand elle échoue. Gardez le score global pour information. Appuyez-vous sur les segments pour la décision.
Passez à la pratique dans Bokili
Transformez cette lecture en mission de dix minutes.
- Commencer
Vérifiez les chiffres avant de les utiliser
Ajoutez une seconde vérification aux calculs et aux chiffres communiqués.
- Commencer
Séparez la vérification de la décision
Testez si une réponse vérifiée change réellement le niveau de confiance.
- Commencer
Vérifiez le transfert dans le temps
Voyez si la compétence tient sur un nouveau cas après la formation.
Sources
- AI Risk Management Framework Core — NIST AI Resource Center
- AI Risks and Trustworthiness — NIST AI Resource Center
- Guidance on the Impact Evaluation of AI Interventions — HM Treasury and Evaluation Task Force
- Artificial Intelligence Playbook for the UK Government — Government Digital Service
- Model Cards for Model Reporting — Google Research
Lire, c'est bien. Pratiquer, ça change tout.
Bokili transforme ce type de compétence en missions de dix minutes pour toute l'équipe, avec un retour immédiat et une progression visible.
CommencerÀ lire ensuite
Formation IA pour les RH : synthèses d’absence sans inférence médicale
Apprenez aux équipes RH à rédiger une synthèse d'absence purement opérationnelle, sans exposer de données de santé, inventer des motifs ou laisser l'IA prendre une décision.
Licences IA : allouer l’accès aux tâches prêtes, pas aux listes d’attente
Qualifiez les demandes de licence IA avec 4 critères : source validée, résultat clair, responsable de la validation et circuit de support.
Compétences IA des salariés : calibrer la confiance avant de vérifier
Formez vos équipes à noter leur confiance avant de consulter l'IA, à vérifier l'information clé et à apprendre de l'écart entre prédiction et faits.