Durchschnittliche KI-Scores können wichtige Fälle verschleiern
Ein gutes Gesamtergebnis kann schwache, kritische Teilergebnisse verdecken. Testen Sie KI nach Aufgabe, Kontext und Auswirkung, bevor der Durchschnitt die Entscheidung bestimmt.
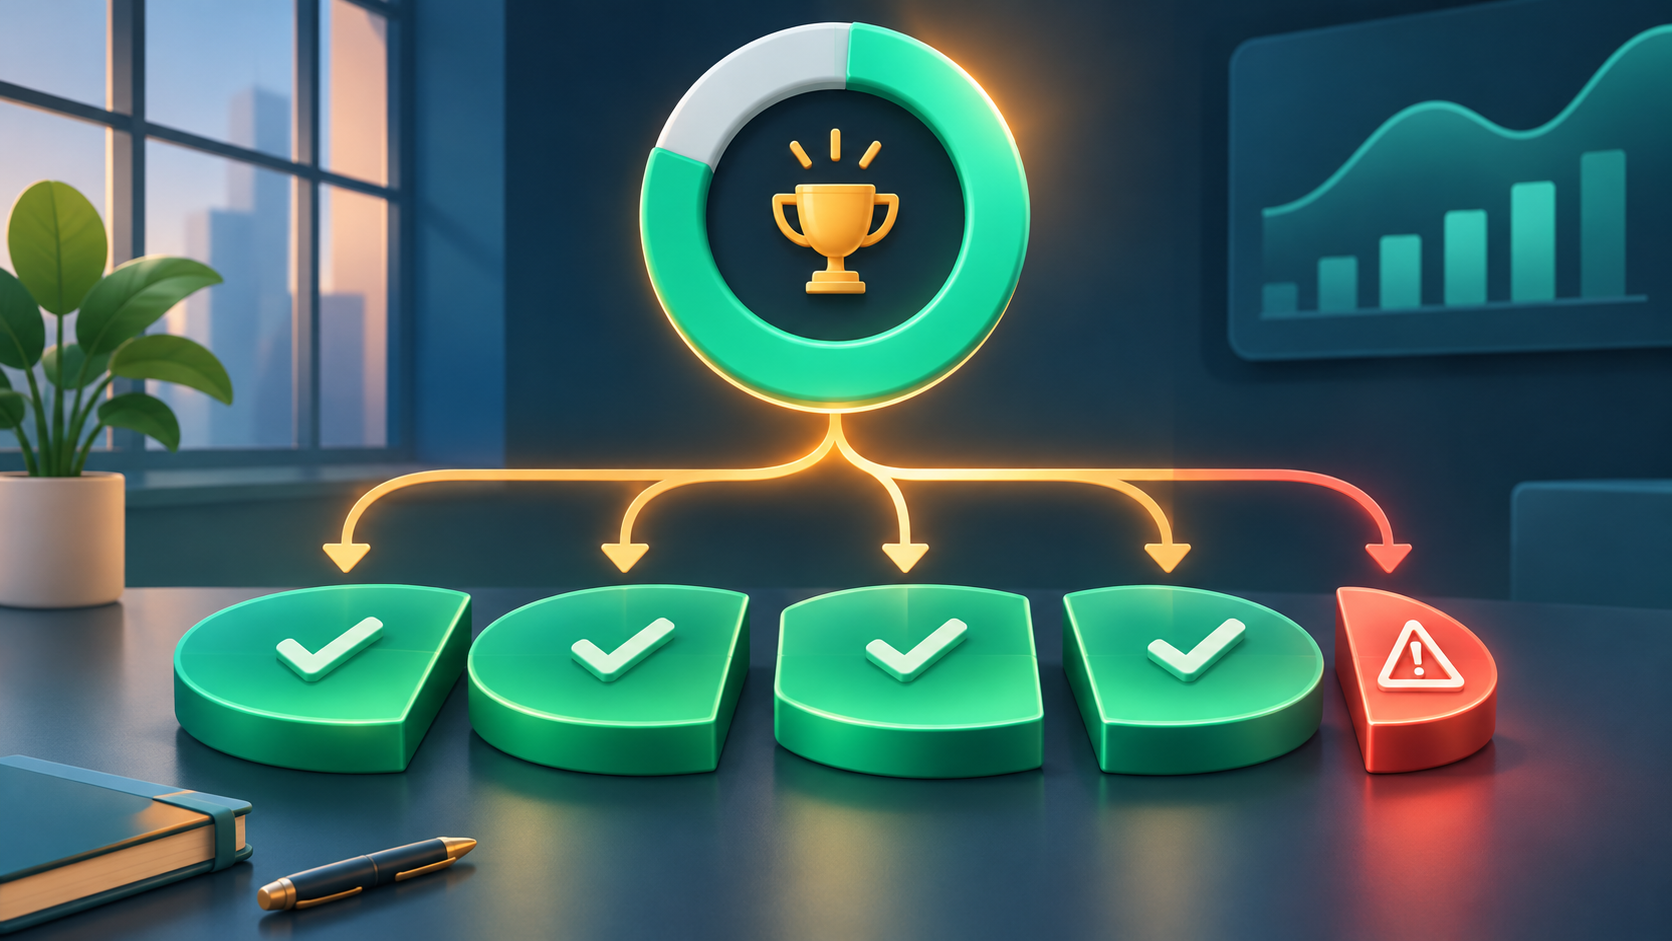
Ein einzelner KI-Testwert ist leicht zu wiederholen: 91 % genau, 4,3 von 5 oder „46 von 50 Fällen bestanden“. Er ist aber auch leicht misszuverstehen. Der Durchschnitt kann Routineaufgaben und kritische Fälle, häufige und seltene Eingaben, klare und mehrdeutige Anfragen oder ungleich repräsentierte Nutzergruppen vermischen. Vier starke Teilergebnisse können ein schwaches verschwinden lassen.
Die Lösung ist nicht, Durchschnittswerte abzulehnen, sondern sie zu validieren. Bevor ein Ergebnis die Einführung begründet, zerlegen Sie die Bewertung in Fälle, in denen Leistung, Konsequenz oder Nutzererfahrung abweichen können. Das AI Risk Management Framework von NIST fordert realistische Testdatensätze, dokumentierte Bedingungen und Grenzen der Generalisierbarkeit. Auch britische Richtlinien warnen, dass KI-Auswirkungen je nach Aufgabe, Kontext und Gruppe variieren. Ein Ergebnis ohne diese Bedingungen ist eine Schlagzeile, noch keine Entscheidung.
Der Durchschnitt beantwortet die falsche Frage
| Nur Gesamttest | Test nach Segmenten | |
|---|---|---|
| Frage | Wie hat das System insgesamt abgeschnitten? | Wo ändert sich die Leistung so stark, dass sich die Nutzung ändern muss? |
| Testset | Eine zusammengefasste Stichprobe | Benannte Segmente nach Aufgabe, Kontext und Auswirkung |
| Ergebnis | Ein Mittelwert oder eine Erfolgsquote | Gesamtergebnis plus jedes wichtige Segment |
| Entscheidung | Einsetzen oder ablehnen | Einsetzen, begrenzen, überarbeiten, Prüfung ergänzen oder stoppen |
Angenommen, ein interner Assistent beantwortet 88 von 100 Richtlinienfragen korrekt. Das klingt nützlich. Aber die 100 Fälle enthalten 80 häufige Fragen, 15 regionale Varianten und fünf dringende Ausnahmen. Beantwortet er 76 häufige Fragen, zehn regionale und nur zwei dringende Ausnahmen korrekt, bleibt das Gesamtergebnis bei 88 %. Das Teilergebnis, das den größten Schaden verursachen könnte, ist das schwächste. Mehr einfache Fälle würden den Durchschnitt verbessern, ohne diese Schwäche zu beheben.
Nutzen Sie SLICE, bevor Sie dem Score vertrauen
SLICE: Fünf Fragen für eine aussagekräftige Bewertung
S — Entscheidung festlegen
Legen Sie fest, was das Ergebnis autorisiert: Pilot, eingeschränkte Nutzung, breiterer Einsatz, Pflichtprüfung oder keine Nutzung.
L — Segmente auflisten
Benennen Sie Aufgaben, Sprachen, Eingabebedingungen, Nutzerkontexte und Konsequenzen, bei denen die Leistung abweichen könnte.
I — Jedes Segment prüfen
Geben Sie Stichprobe, Metrik, Unsicherheit und Fehlermuster für jedes Segment an, nicht nur den Gesamtwert.
C — Konsequenzen vergleichen
Gewichten Sie einen seltenen, folgenschweren Fall nicht so, als wäre er mit einem Routinefall austauschbar.
E — Grenzen festlegen
Legen Sie den Weg für schwache oder ungetestete Segmente fest: manuelle Prüfung, engerer Rahmen, mehr Tests, Redesign oder Stopp.
Lesen ist der Anfang. Üben macht den Unterschied.
Jetzt startenSLICE ist eine Entscheidungshilfe, keine statistische Abkürzung. Manche Segmente sind für stabile Prozentwerte zu klein. Weisen Sie darauf hin. Nutzen Sie qualitative Prüfungen, gezielte Stresstests und Fachexperten, statt Präzision zu fingieren. Die „Model Cards“-Forschung schlug Leistungsberichte für relevante Bedingungen und Gruppen vor, weil die Eignung eines Modells vom Anwendungsfall abhängt. Auch das UK AI Playbook behandelt Tests, Validierung und Monitoring als Lebenszyklus-Aufgaben, nicht als einmaliges Startsignal.
Praxisbeispiel: Richtlinien mit unterschiedlichen Konsequenzen
Ein Unternehmen testet einen KI-Assistenten für Fragen zur Spesenrichtlinie. Das gängige Segment umfasst Pauschalen, Belege und Kilometergeld. Das regionale Segment deckt Währungen und lokale Steuervorschriften ab. Das Ausnahme-Segment betrifft medizinische Reisen, Barrierefreiheit und Notfallbuchungen. Der Assistent ist bei gängigen Fragen gut, vermischt aber manchmal regionale Regeln und vergisst bei Ausnahmen oft den Genehmiger. Das Problem wird nicht „weggemittelt“. Stattdessen darf das Tool Antworten für gängige Fragen entwerfen, bei regionalen Fragen sind Quellenangabe und menschliche Prüfung Pflicht, und Ausnahmefälle gehen direkt an das zuständige Team, bis ein neuer Test die Zuverlässigkeit beweist.
Was neben jedem KI-Testwert stehen sollte
- Die vorgesehene Entscheidung und eine verantwortliche Person
- Die im Testset vertretenen Bedingungen
- Die wichtigen Segmente und warum sie relevant sind
- Stichprobengröße und Unsicherheit für jedes Segment
- Fehlerarten statt nur Erfolgsquoten
- Personen, Kontexte oder Fälle, die im Test fehlen
- Die Einsatzgrenze für schwache oder ungetestete Segmente
- Datum, Version und Auslöser für den nächsten Test
Test auf versteckte Segmente (10 Min.)
- Wählen Sie ein KI-Evaluationsergebnis, das Ihr Team bereits nutzt.
- Notieren Sie die Arbeitsentscheidung, die dieses Ergebnis unterstützen soll.
- Teilen Sie die Fälle nach Aufgabentyp, Auswirkung und einem leistungsrelevanten Kontext auf.
- Berechnen oder prüfen Sie jedes Segment separat.
- Markieren Sie das schwächste oder am wenigsten getestete folgenreiche Segment.
- Legen Sie eine Einsatzgrenze oder einen zusätzlichen Test fest, bevor eine breitere Nutzung erlaubt wird.
Eine verantwortungsvolle Bewertung fragt nicht nur, ob die KI funktioniert. Sie fragt, wo sie funktioniert, für wen, unter welchen Bedingungen und was passiert, wenn nicht. Behalten Sie den Gesamtwert zur Orientierung. Legen Sie für die Entscheidung die Teilergebnisse daneben.
In Bokili üben
Machen Sie aus dem Gelesenen eine Zehn-Minuten-Mission.
- Jetzt starten
Zahlen vor der Nutzung prüfen
Prüfen Sie Berechnungen und ausgewiesene Zahlen ein zweites Mal.
- Jetzt starten
Prüfung und Entscheidung trennen
Testen Sie, ob ein geprüftes Ergebnis die tatsächliche Nutzung verändert.
- Jetzt starten
Verzögerten Transfer prüfen
Prüfen Sie, ob die Fertigkeit später auf einen neuen Fall übergeht.
Quellen
- AI Risk Management Framework Core — NIST AI Resource Center
- AI Risks and Trustworthiness — NIST AI Resource Center
- Guidance on the Impact Evaluation of AI Interventions — HM Treasury and Evaluation Task Force
- Artificial Intelligence Playbook for the UK Government — Government Digital Service
- Model Cards for Model Reporting — Google Research
Lesen ist der Anfang. Üben macht den Unterschied.
Bokili macht aus solchen Fähigkeiten Zehn-Minuten-Missionen für das ganze Team – mit sofortigem Feedback und sichtbarem Fortschritt.
Jetzt startenWeiterlesen
KI-Schulung für HR: Abwesenheitsnotizen ohne Gesundheitsannahmen
So erstellen HR-Teams eine minimale, operative Abwesenheitsnotiz – ohne Gesundheitsdetails preiszugeben, Ursachen zu erfinden oder Personalentscheidungen der KI zu überlassen.
KI-Lizenzen für einsatzbereite Aufgaben statt Wartelisten
Nutzen Sie vier Bereitschafts-Gates, um knappe KI-Zugänge für Aufgaben mit genehmigter Eingabe, klarem Ergebnis, Prüfverantwortlichem und Support-Route zuzuweisen.
KI-Kompetenzen für Mitarbeitende: Vertrauen vorab kalibrieren
Trainieren Sie Mitarbeitende, ihr Vertrauen vor der KI-Empfehlung zu bewerten, die entscheidende Aussage zu prüfen und aus der Lücke zwischen Prognose und Fakten zu lernen.