Bevor Sie ein KI-Pilotprojekt skalieren: Exit-Regeln festlegen
Legen Sie die Kriterien für Wiederholung, Skalierung oder Beendigung eines KI-Pilotprojekts fest, bevor eine überzeugende Demo die Entscheidung für Sie trifft.
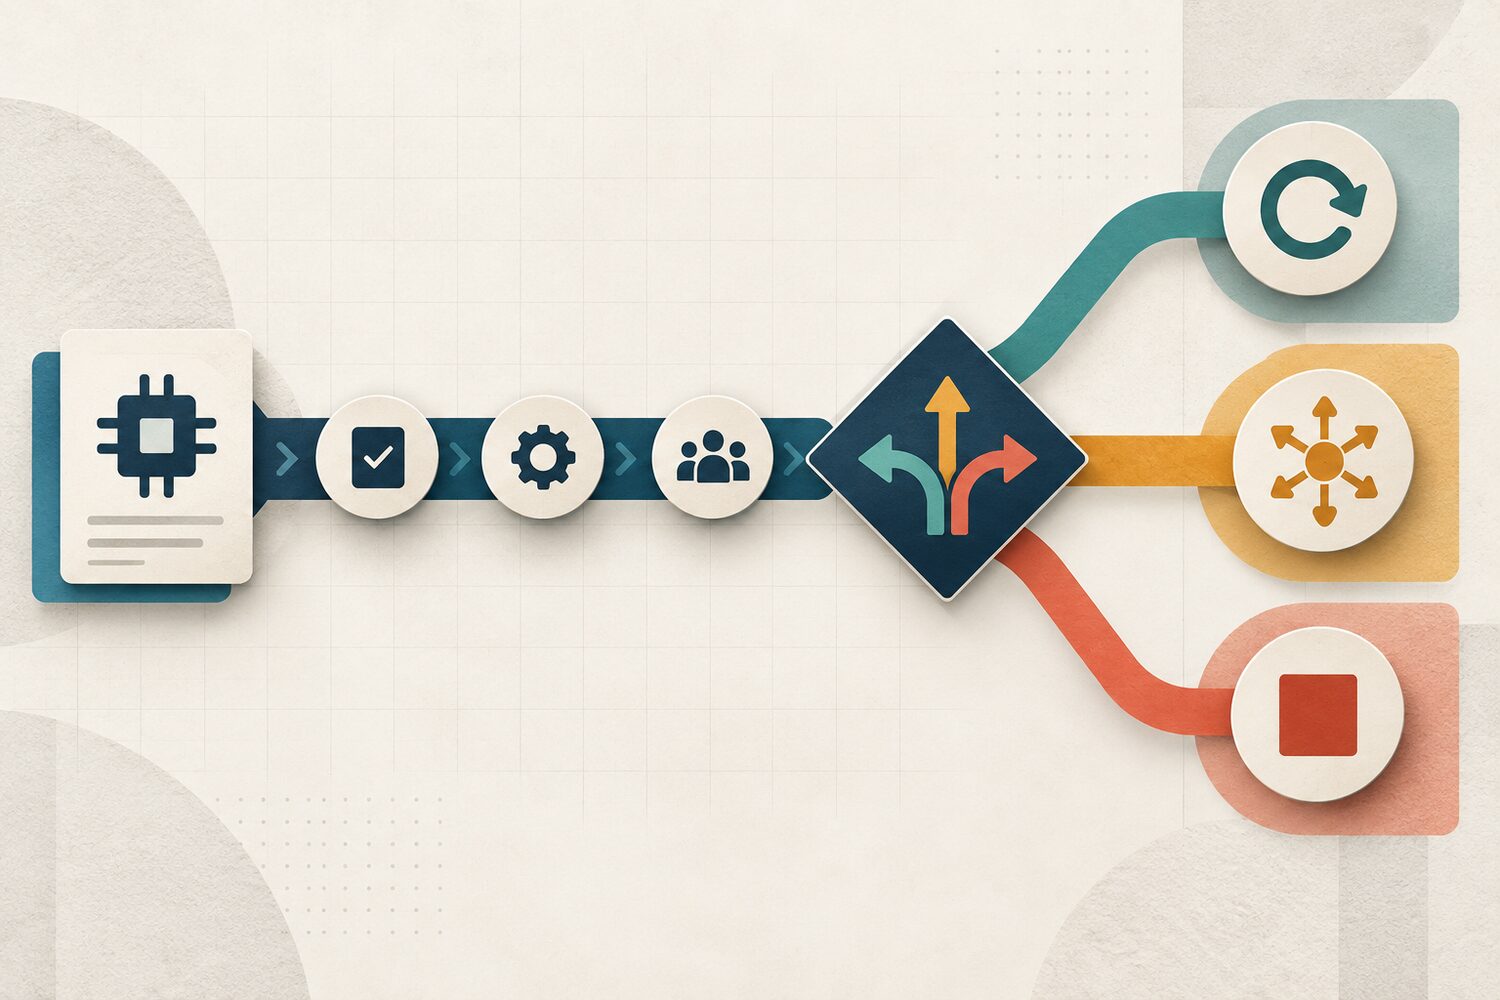
Ein KI-Pilotprojekt sollte nicht mit einer Präsentation namens „vielversprechende Ergebnisse“ enden, sondern mit einer Entscheidung. Bevor der erste Teilnehmer, die erste Aufgabe oder der erste Test in das Pilotprojekt einfließt, legen Sie die Kriterien fest, die eine von drei Exit-Optionen rechtfertigen: das Experiment wiederholen, den Workflow skalieren oder die Bemühungen einstellen und neu ausrichten.
Ohne diese Regeln kann eine überzeugende Demo fälschlicherweise als operative Bereitschaft angesehen werden. Das UK Government AI Playbook beschreibt gestufte Experimente, Genauigkeitsschwellen und Evaluation über den gesamten Projektlebenszyklus. NIST empfiehlt ebenfalls die Dokumentation von Testsets, Metriken, Methoden und Leistungsergebnissen, um die Evaluierung wiederholbar zu machen. Die praktische Implikation ist einfach: Definieren Sie die Entscheidung, bevor Sie das Ergebnis sehen.
Drei Exit-Regeln für ein KI-Pilotprojekt
Wiederholen, skalieren oder stoppen
Wiederholen, um eine Lücke zu schließen
Führen Sie einen weiteren begrenzten Zyklus nur dann durch, wenn der Nutzen plausibel bleibt und eine benannte Unsicherheit mit einer spezifischen Änderung getestet werden kann.
Mit Kontrollen skalieren
Erweitern Sie nur, wenn Aufgabenqualität, operative Schutzmaßnahmen und fortlaufender Support alle die vorab vereinbarten Schwellenwerte erfüllen.
Stoppen oder neu ausrichten
Beenden Sie das Pilotprojekt, wenn das Ergebnis nicht nützlich ist, das Risiko nicht kontrolliert werden kann oder der Überprüfungs- und Supportaufwand den Nutzen zunichtemacht.
Dies sind keine drei Stimmungen. Jede benötigt Belege. „Die Leute mochten es“ mag eine weitere Erkundung unterstützen, kann aber nicht beweisen, dass der Workflow bei größerem Volumen präzise, sicher oder unterstützbar ist. „Das Modell produzierte ein gutes Beispiel“ sagt wenig darüber aus, wie oft ein Prüfer eingreifen muss, welche Fälle fehlschlagen oder ob das Team den Prozess aufrechterhalten kann.
Bereitschaft messen, nicht nur Begeisterung
| Demo evidence | Scale evidence | |
|---|---|---|
| Aufgabenergebnis | One persuasive output | A defined test set assessed against explicit acceptance criteria |
| Menschliche Arbeit | A reviewer corrected the example | Review time, escalation points and decision rights are understood |
| Risiko | No problem appeared in the demo | Known failure modes have controls, owners and stop conditions |
| Betrieb | The pilot team made it work | A normal team can repeat, monitor and support the workflow |
Nutzen Sie drei Evidenz-Gates. Das Aufgaben-Gate fragt, ob das Ergebnis für den beabsichtigten Zweck in repräsentativen Fällen gut genug ist. Das Kontroll-Gate fragt, ob Daten-, Genehmigungs-, Eskalations- und menschliche Überprüfungsregeln tatsächlich funktionieren. Das Support-Gate fragt, ob der Workflow wiederholt werden kann, ohne auf den enthusiastischsten Experten des Pilotprojekts angewiesen zu sein.
Ein Pilotprojekt kann das Aufgaben-Gate bestehen und trotzdem am Support-Gate scheitern. Das ist keine enttäuschende Randnotiz, sondern das Ergebnis. Die GOV.UK Chat Fallstudie zeigte beispielsweise, dass eine hochgradig manuelle Qualitätssicherung nicht skalierbar wäre und identifizierte die Notwendigkeit eines qualitätsgeprüften Fragensets. Die Lektion ist breiter als Chatbots: Skalierung verändert das operative Problem.
Praxisbeispiel: ein Briefing zur Lieferantenintegration
Lesen ist der Anfang. Üben macht den Unterschied.
Jetzt startenStellen Sie sich vor, ein Einkaufsteam pilotiert einen KI-Workflow, der fiktive Lieferantendokumente in ein Onboarding-Briefing umwandelt. Das Team verwendet ein festes Paket von Musterdokumenten, darunter ein fehlendes Zertifikat, eine inkonsistente Zahlungsbedingung und einen klaren Fall. Ein menschlicher Prüfer trifft die endgültige Entscheidung.
Exit-Karte vor dem Test schreiben
- 1
Aufgabenschwelle definieren
Das Briefing muss alle wesentlichen Fakten bewahren, fehlende Belege kennzeichnen und das Erfinden einer Schlussfolgerung vermeiden. Das Testset und die Bewertungsmethode werden aufgezeichnet.
- 2
Kontrollschwelle definieren
Es werden keine Live-Lieferantendaten in die Übung eingegeben. Jede Ausnahme hat einen Eskalationsweg, und der Prüfer weiß, welche Felder nicht aus der KI-Ausgabe genehmigt werden können.
- 3
Supportschwelle definieren
Ein zweites Teammitglied kann den Workflow anhand der schriftlichen Anweisungen ausführen, häufige Fehler diagnostizieren und Änderungen aufzeichnen, ohne Hilfe vom Pilotdesigner.
- 4
Entscheidung zuweisen
Der Sponsor zeichnet auf, welche überschrittene Schwelle eine Wiederholung auslöst, welche Kombination eine begrenzte Skalierung erlaubt und welche Bedingung das Pilotprojekt beendet.
Angenommen, die Briefings sind in einfachen Fällen korrekt, übersehen aber die inkonsistente Zahlungsbedingung. Die richtige Exit-Option ist nicht „vorsichtig skalieren“. Es ist eine Wiederholungsentscheidung mit einer benannten Frage: Kann der Workflow zuverlässig vertragliche Widersprüche aufdecken, nachdem der Prompt, das Quellpaket oder die Überprüfungscheckliste geändert wurde? Der nächste Zyklus dient dazu, diese Frage zu beantworten, nicht dazu, das Pilotprojekt am Leben zu erhalten.
Das endlose Pilotprojekt verhindern
Eine Wiederholungsregel benötigt eine eigene Grenze. Legen Sie die Änderung, die erwarteten Nachweise und die maximale Anzahl von Zyklen fest. Wenn jede Runde ein anderes Ziel einführt, testet die Organisation kein Pilotprojekt mehr; sie verschiebt eine Entscheidung. Bewahren Sie das Änderungsprotokoll auf, damit verbesserte Ergebnisse auf einen geänderten Prompt, ein Modell, eine Aufgabengrenze oder einen Überprüfungsprozess zurückgeführt werden können.
Auch die Skalierung sollte stufenweise erfolgen. Ein Workflow, der innerhalb eines Teams funktioniert, benötigt möglicherweise ein weiteres kontrolliertes Gate, bevor er Funktionen, Länder oder Risikostufen überschreitet. Neue Benutzer und Betriebsbedingungen können Fehler aufdecken, die im ersten Test nicht vorhanden waren. NIST weist darauf hin, dass der Kontext beeinflusst, welche Bewertungsmethoden angemessen sind, und dass Messungen neu bewertet werden sollten, wenn sich die operativen Einstellungen ändern.
- Name the exact work task and the decision the pilot is meant to inform.
- Write one observable pass condition for task quality, controls and supportability.
- Define the single uncertainty that would justify a repeat cycle.
- Name one condition that forces a stop or redesign.
- Assign the person who records the decision and the evidence behind it.
Machen Sie die Entscheidung zum Ergebnis
Ein Pilot ist nicht erfolgreich, weil er durchgeführt oder weil Teilnehmer engagiert waren. Er ist erfolgreich, wenn er vertrauenswürdige Belege für eine Entscheidung liefert. Definieren Sie „wiederholen“, „skalieren“ und „stoppen“, bevor die Arbeit beginnt; dann lassen Sie die Belege den Weg weisen.
Bokili hilft Teams, die Verhaltensweisen hinter diesen Schranken in kurzen, fokussierten Missionen zu üben. Verbinden Sie die Exit-Card mit verwandten Anleitungen zum Trainieren der Workflow-Einschränkung, zum Umwandeln von Dashboard-Signalen in Unterstützung und zum Entscheiden, was aus der eingesparten Zeit wird.
Quellen
- Artificial Intelligence Playbook for the UK Government — UK Government
- AI RMF Playbook — Measure — NIST
- Planning & Evaluating — U.S. Office of Personnel Management
Lesen ist der Anfang. Üben macht den Unterschied.
Bokili macht aus solchen Fähigkeiten Zehn-Minuten-Missionen für das ganze Team – mit sofortigem Feedback und sichtbarem Fortschritt.
Jetzt startenWeiterlesen
ChatGPT-Schulung für Mitarbeitende: Sicheres Übungspaket bauen
Erstellen Sie realistische ChatGPT-Trainings für Mitarbeitende mit fiktiven Fakten, Grenzbereichen, Bewertungskriterien und einer Musterlösung – ohne Live-Arbeitsdaten zu importieren.
KI-Lernpfad: Jede Erstellung mit einer Prüfung verbinden
Ein KI-Lernpfad, der das Erstellen nützlicher Ergebnisse mit Prüfungen von Quellen, Vorgaben, Annahmen und Entscheidungsgrenzen verbindet.
Gemini Notebook: Eine Behauptung anhand einer Quelle prüfen
Eine gezielte Quellenprüfung wandelt eine flüssige Antwort in überprüfbare Belege um, bevor Sie das Notebook erweitern.